ITIL: Gestión de Incidentes



Este blog cubre las áreas de conocimiento clave de la Gestión de Incidentes.
- Visión general de la gestión de incidentes
- Ciclo de vida del incidente
- Escalada de incidentes
- Escalada funcional frente a escalada jerárquica
- Beneficios, costes y retos
Lo primero es lo primero: antes de profundizar en cada área, es mejor tener una buena idea de las terminologías básicas y fundamentales. Para aquellos de ustedes que planeen presentarse al examen de ITIL, esto será muy importante saberlo. Por ejemplo, ¿qué es un "Incidente"?
Según el Glosario ITIL:
Incident: (Service Operations) An unplanned interruption of an IT Service or a reduction in the quality of an IT Service. Failure of a configuration item that has not yet impacted service is also an incident. For example: Failure of one disk from a mirror set.
Incident Management: (Service Operations) The process responsible for managing the lifecycle of all incidents. The primary objective of incident management is to return the IT Service to users as quickly as possible.
Estas dos definiciones son muy importantes de conocer y se preguntan con bastante frecuencia en el examen de ITIL.
Visión general de la gestión de incidentes
- Disminuir o incluso eliminar los efectos o incidencias de las interrupciones informáticas, las perturbaciones o la reducción de la calidad.
- Los usuarios deben volver al trabajo lo antes posible
- Contratar a especialistas adecuados para registrar, clasificar y asignar todos los incidentes.
- Se debe supervisar el progreso
- Las incidencias deben resolverse TODAS
- El proceso debe cerrarse DESPUÉS de la resolución
Objetivos y ventajas de la gestión de incidentes
- Reducir el impacto en la empresa
- Mejorar la productividad de los usuarios
- Obtener una supervisión de incidentes independiente y centrada en el cliente
- Facilitar la información sobre los ANS (Acuerdos de Nivel de Servicio)
- Menor coste de la actividad empresarial
- Reaccionar con rapidez y eficacia
- Supervisión activa de los dominios y servicios de los usuarios
- Evitar que los problemas se agraven
- Mayor satisfacción del usuario/cliente
- Operaciones más precisas
- Evitar "demasiados cocineros
Ya hemos definido las "Incidencias". Veamos ahora el "Problema".
Problems cause incidences. Incidences do not become problems. The problem is the underlying, unknown cause of one or more incidences. For example, one of the hard drives failed. If a disk fails, that is the incident. The problem however, is the underlying cause of the incident. Is it a configuration issue? Hardware issue? It is very important to remember the difference between an incident and a problem.
Registros de incidentes frente a registros de problemas:
- Incident Records are end-user focused
- La gestión de informes de incidentes se centra en la medición del tiempo de inactividad y el impacto en la empresa
- Problem Records start with IT Management’s decision to invest IT resources and end-user downtime for root cause investigation and implementation of resolution
- Problem Records focus on Internal IT Processes
- Gestión Elaboración de informes sobre problemas, centrándose en las causas profundas y aplicando soluciones estructurales.
Ciclo de vida del incidente
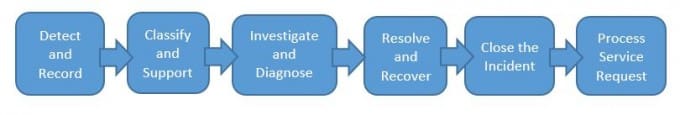
Como gestor de incidencias, mientras prepara su solución de Service Desk y gestión de incidencias, a continuación se muestra un diagrama típico del ciclo de vida de las incidencias con el que posiblemente podría estar trabajando.
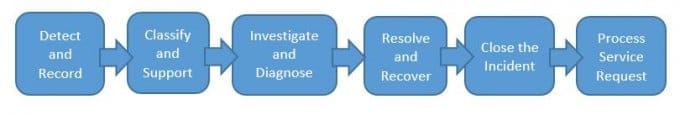
El primer paso es Detectar y Registrar. Se trata de la aceptación original de la solicitud al Service Desk. En ese momento, se crea el Registro de Incidentes. El segundo paso es clasificar y dar soporte. Por ejemplo, ¿el problema está relacionado con software o hardware , o es una solicitud de servicio? El incidente se codifica según el tipo de incidente, el estado o su impacto en la organización. ¿Es urgente? ¿Es crítica? ¿Cuál es su prioridad? ¿Qué relación tiene con el Acuerdo de Nivel de Servicio? A partir de ahí, el usuario puede recibir sugerencias del Service Desk basadas en el guión, o quizás, basadas en la experiencia para resolver el incidente o solucionar el problema, aunque sólo sea una solución temporal. Si se trata de una Solicitud de Servicio, en ese momento pasaríamos a un proceso diferente, ya que la Solicitud de Servicio no implica los pasos de Investigación y Diagnóstico.
If there are no known solutions for this particular incident, then it will be investigated and diagnosed further by the Service Desk group or go through the escalation process. If the solution was found, the issue can then be “resolved.” The “Resolve and Recover” step must take place. We have to have a solution to the incident. Once we have resolution to the incident, we move on to Closure. The user is asked if they are satisfied with the resolution. If they are, we close the incident. We might have a survey or a follow up if we wish to improve this process.
A lo largo de cada paso del camino, debemos hacer un seguimiento continuo y supervisar los progresos.
Escalada de incidentes
Aquí tenemos dos tipos diferentes de escalado: Escalado horizontal y escalado vertical (esto también se pregunta con frecuencia en el examen de Fundamentos de ITIL). En pocas palabras, el Escalado de Incidentes consiste en pasar el problema a un personal de mayor nivel de experiencia/autoridad.
Toda organización debería tener un modelo de escalada. Hagamos un repaso en términos sencillos para demostrarlo.
A un nivel muy básico, en primer lugar tenemos el Nivel 1. Este nivel se encarga de registrar y detectar el incidente. Esto vendrá en forma de algún tipo de petición. Puede ser de un usuario, cliente, sistema, aplicación, etc. Si la petición es una Solicitud de Servicio, por ejemplo, un nuevo empleado necesita configurar una cuenta de dominio, entonces este tipo de petición, como se mencionó anteriormente, pasaría por un Procedimiento de Solicitud de Servicio. Una vez que la incidencia llega a nuestra línea de Nivel 1, pasará al siguiente paso, Soporte. Si nuestro servicio de asistencia puede resolver la incidencia, pasamos directamente a la recuperación de la resolución y cerramos la incidencia.
Sin embargo, si el Support Desk no ha sido capaz de resolver la incidencia, entra en juego el escalado, lo que denominamos Tier 2. Este escalado, como ya se ha mencionado, puede ser horizontal o vertical.
- La escalada funcional (horizontal) es un proceso que consiste en incorporar a compañeros de trabajo, personal interno con conocimientos especiales o privilegios de acceso adicionales.
- La escalada jerárquica (vertical) implica dirigirse a niveles superiores. Por ejemplo, cuando se trata de un problema de red, tendríamos que ponernos en contacto con nuestro centro de datos, que está fuera de nuestra organización.
Desde el punto de vista del diseño del Service Desk, querríamos desarrollar primero la Escalada Horizontal para asegurarnos de que tenemos personal para dar soporte a nuestros usuarios.
Beneficios, costes y retos de la gestión de incidentes
Veamos primero las ventajas de la gestión de incidentes:
- La reducción del impacto en la empresa de los problemas e incidentes, incluidas las solicitudes de servicio, permite una mayor eficacia.
- It will allow you to put in place proactive enhancements and changes that will make your business run smooth
- Gestión de SLA orientada a la empresa
- By improving monitoring and performance, we receive better service quality
- Mejor utilización y eficiencia del personal
- By learning from incidents and problems, it will allow us to eliminate future incidents and service requests
- Ayúdenos a mejorar la satisfacción del cliente/usuario
Todo tiene su precio y sus retos. La gestión de incidentes también los tiene:
- Planificación y ejecución iniciales - comunicación, proceso de formación
- Formación y puesta en marcha
- Hardware y software herramientas que se utilizarán (sistema de supervisión, sistema de tickets)
- Los usuarios/el personal se saltan los procedimientos; si el proceso es demasiado complejo o burocrático
- Atasco de incidentes - sobrecarga de procesos
- Demasiadas escaladas
- Falta de definiciones claras, acuerdos de nivel de servicio y compromiso del personal y la dirección.
Como puede ver, la implantación de un proceso de gestión de incidencias tiene muchas ventajas y toda organización debería tener un proceso de gestión de incidencias claramente definido si desea prestar un apoyo eficaz a sus clientes internos y externos.
Suscríbase a The Source
Stay secure with Keyfactor's monthly newsletter, packed with expert insights and practical steps for quantum-readiness.
Continuar leyendo
Conclusiones clave de la Conferencia de Criptografía Postcuántica del Consorcio PKI
Leer más
Las normas que defiende Keyfactor
Leer más