ITIL-Vorfallmanagement



Dieser Blog behandelt die wichtigsten Wissensbereiche des Incident Management.
- Überblick über das Incident Management
- Lebenszyklus von Vorfällen
- Vorfall-Eskalation
- Funktionale vs. hierarchische Eskalation
- Vorteile, Kosten und Herausforderungen
Das Wichtigste zuerst: Bevor wir tiefer in die einzelnen Bereiche einsteigen, ist es am besten, eine gute Vorstellung von den grundlegenden, fundamentalen Terminologien zu haben. Für diejenigen unter Ihnen, die vorhaben, die ITIL-Prüfung abzulegen, ist es sehr wichtig, diese zu kennen. Was ist zum Beispiel ein "Vorfall"?
Laut ITIL-Glossar:
Incident: (Service Operations) An unplanned interruption of an IT Service or a reduction in the quality of an IT Service. Failure of a configuration item that has not yet impacted service is also an incident. For example: Failure of one disk from a mirror set.
Incident Management: (Service Operations) The process responsible for managing the lifecycle of all incidents. The primary objective of incident management is to return the IT Service to users as quickly as possible.
Diese beiden Definitionen sind sehr wichtig und werden in der ITIL-Prüfung recht häufig abgefragt.
Überblick über das Incident Management
- Verringerung oder sogar Beseitigung der Auswirkungen oder des Auftretens von IT-Unterbrechungen, -Störungen oder Qualitätsminderungen
- Benutzer müssen so schnell wie möglich wieder arbeiten können
- Beauftragung geeigneter Spezialisten mit der Erfassung, Klassifizierung und Zuordnung aller Vorfälle
- Die Fortschritte sollten überwacht werden
- Vorfälle müssen ALLE geklärt werden
- Prozess muss NACH der Lösung abgeschlossen werden
Ziele und Vorteile von Incident Management
- Verringerung der Auswirkungen auf das Geschäft
- Verbesserung der Benutzerproduktivität
- Unabhängige, kundenorientierte Überwachung von Vorfällen
- SLA-Informationen (Service Level Agreement) leicht zugänglich machen
- Niedrigere Kosten für die Geschäftstätigkeit
- Reagieren Sie schnell und effizient
- Aktive Überwachung von Benutzerdomänen und Diensten
- Probleme vor der Eskalation bewahren
- Verbesserte Nutzer-/Kundenzufriedenheit
- Genauere Operationen
- Verhindern von "zu vielen Köchen"
Wir haben bereits "Vorkommnisse" definiert. Schauen wir uns jetzt das "Problem" an.
Problems cause incidences. Incidences do not become problems. The problem is the underlying, unknown cause of one or more incidences. For example, one of the hard drives failed. If a disk fails, that is the incident. The problem however, is the underlying cause of the incident. Is it a configuration issue? Hardware issue? It is very important to remember the difference between an incident and a problem.
Aufzeichnungen über Vorfälle vs. Problemaufzeichnungen:
- Incident Records are end-user focused
- Incident Reporting Management konzentriert sich auf die Messung von Ausfallzeiten und Auswirkungen auf das Geschäft
- Problem Records start with IT Management’s decision to invest IT resources and end-user downtime for root cause investigation and implementation of resolution
- Problem Records focus on Internal IT Processes
- Management Berichterstattung über Probleme mit Schwerpunkt auf den Grundursachen und Umsetzung struktureller Lösungen
Lebenszyklus von Vorfällen
Während Sie als Incident Manager Ihre Service Desk Lösung und Incident Handling zusammenstellen, sehen Sie unten ein typisches Incident Life Cycle Diagramm, mit dem Sie möglicherweise arbeiten könnten.
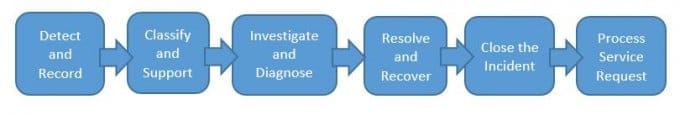
Der allererste Schritt ist das Erkennen und Aufzeichnen. Dies ist die ursprüngliche Annahme der Anfrage an den Service Desk. Zu diesem Zeitpunkt wird der Incident Record erstellt. Der zweite Schritt ist die Klassifizierung und Unterstützung. Handelt es sich zum Beispiel um ein Problem im Zusammenhang mit software oder hardware oder um eine Serviceanfrage? Der Vorfall wird nach der Art des Vorfalls, dem Status oder den Auswirkungen auf die Organisation kodiert. Ist es dringend? Ist er kritisch? Welche Priorität hat er? Wie verhält es sich mit dem Service Level Agreement? Von dort aus kann der Benutzer vom Service Desk Vorschläge erhalten, die auf dem Skript basieren, oder vielleicht auf der Grundlage von Expertenwissen, um den Vorfall zu lösen oder das Problem zu umgehen, selbst wenn es sich nur um eine vorübergehende Lösung handelt. Wenn es sich um eine Serviceanfrage handelt, würden wir an diesem Punkt zu einem anderen Prozess übergehen, da die Serviceanfrage nicht die Schritte der Untersuchung und Diagnose umfasst.
If there are no known solutions for this particular incident, then it will be investigated and diagnosed further by the Service Desk group or go through the escalation process. If the solution was found, the issue can then be “resolved.” The “Resolve and Recover” step must take place. We have to have a solution to the incident. Once we have resolution to the incident, we move on to Closure. The user is asked if they are satisfied with the resolution. If they are, we close the incident. We might have a survey or a follow up if we wish to improve this process.
Auf jedem Schritt des Weges sollten wir eine kontinuierliche Verfolgung und Fortschrittskontrolle durchführen.
Vorfall-Eskalation
Hier gibt es zwei verschiedene Eskalationsarten: Horizontale Eskalation und vertikale Eskalation (diese Frage wird auch häufig im ITIL Foundation Test gestellt). Kurz gesagt, ist die Eskalation eines Vorfalls die Weitergabe des Problems an eine höhere Fach-/Autoritätsebene.
Jede Organisation sollte über ein Eskalationsmodell verfügen. Lassen Sie uns dies mit einfachen Worten erläutern.
Auf einer sehr grundlegenden Ebene haben wir zunächst Stufe 1. Diese Ebene ist für die Aufzeichnung und Erkennung des Vorfalls zuständig. Dies geschieht in Form einer Art von Anfrage. Sie kann von einem Benutzer, Kunden, System, einer Anwendung usw. kommen. Wenn es sich bei der Anfrage um eine Serviceanfrage handelt, z. B. wenn ein neuer Mitarbeiter ein Domänenkonto einrichten möchte, dann würde diese Art von Anfrage, wie bereits erwähnt, ein Serviceanfrageverfahren durchlaufen. Sobald der Vorfall unsere Tier-1-Leitung erreicht, wird er an den nächsten Schritt, den Support, weitergeleitet. Wenn unser Support Desk in der Lage war, den Vorfall zu lösen, gehen wir direkt zur Wiederherstellung der Lösung über und schließen den Vorfall ab.
Wenn der Support Desk jedoch nicht in der Lage war, den Vorfall zu lösen, kommt die Eskalation ins Spiel, die wir als Stufe 2 bezeichnen. Diese Eskalation kann, wie bereits erwähnt, horizontal oder vertikal erfolgen.
- Die funktionale (horizontale) Eskalation ist ein Prozess, bei dem Mitarbeiter oder interne Mitarbeiter mit besonderen Fähigkeiten oder zusätzlichen Zugriffsrechten hinzugezogen werden.
- Bei der hierarchischen (vertikalen) Eskalation geht es darum, sich an eine höhere Ebene zu wenden. Bei einem Netzwerkproblem würden wir uns beispielsweise an unser Rechenzentrum wenden, das sich außerhalb unserer Organisation befindet.
Vom Standpunkt des Service-Desk-Designs aus betrachtet, würden wir zuerst die horizontale Eskalation entwickeln wollen, um sicherzustellen, dass wir Personal haben, das unsere Benutzer unterstützt.
Nutzen, Kosten und Herausforderungen des Störungsmanagements
Werfen wir zunächst einen Blick auf die Vorteile des Vorfallmanagements:
- Geringere Auswirkungen von Problemen und Vorfällen auf das Geschäft, einschließlich Serviceanfragen, ermöglichen eine höhere Effektivität
- It will allow you to put in place proactive enhancements and changes that will make your business run smooth
- Geschäftsorientiertes SLA-Management
- By improving monitoring and performance, we receive better service quality
- Bessere Auslastung und Effizienz des Personals
- By learning from incidents and problems, it will allow us to eliminate future incidents and service requests
- Helfen Sie uns, die Kunden-/Nutzerzufriedenheit zu verbessern
Alles hat seinen Preis und bringt Herausforderungen mit sich. Auch das Vorfallmanagement hat sie:
- Erste Planung und Umsetzung - Kommunikation, Schulungsprozess
- Ausbildung und Anlaufphase
- Hardware und software Tools, die verwendet werden (Überwachungssystem, Ticketingsystem)
- Nutzer/Mitarbeiter umgehen die Verfahren, wenn der Prozess zu komplex oder zu bürokratisch ist
- Rückstau von Vorfällen - Überlastung der Prozesse
- Zu viele Eskalationen
- Mangel an klaren Definitionen, SLAs, Engagement von Mitarbeitern und Management
Wie Sie sehen, bietet die Implementierung eines Vorfallmanagementprozesses viele Vorteile, und jede Organisation sollte über einen klar definierten Vorfallmanagementprozess verfügen, wenn sie ihre internen und externen Kunden wirksam unterstützen will.
Die Quelle abonnieren
Stay secure with Keyfactor's monthly newsletter, packed with expert insights and practical steps for quantum-readiness.
Lesen Sie weiter
Zero Trust in Aktion: Wie Code Signing die Containersicherheit verbessert
Mehr lesen
Zusammenfassung des Webinars - Wie PKI, Krypto und Maschinen die digitale Welt in Schwung bringen
Mehr lesen