Gestion des incidents ITIL



Ce blog couvre les principaux domaines de connaissance de la gestion des incidents.
- Aperçu de la gestion des incidents
- Cycle de vie des incidents
- Escalade des incidents
- Escalade fonctionnelle ou hiérarchique
- Avantages, coûts et défis
Tout d'abord, avant d'approfondir chaque domaine, il est préférable d'avoir une bonne idée de la terminologie de base. Pour ceux d'entre vous qui prévoient de passer l'examen ITIL, il est très important de connaître cette terminologie. Par exemple, qu'est-ce qu'un " incident " ?
Selon le glossaire ITIL :
Incident: (Service Operations) An unplanned interruption of an IT Service or a reduction in the quality of an IT Service. Failure of a configuration item that has not yet impacted service is also an incident. For example: Failure of one disk from a mirror set.
Incident Management: (Service Operations) The process responsible for managing the lifecycle of all incidents. The primary objective of incident management is to return the IT Service to users as quickly as possible.
Ces deux définitions sont très importantes à connaître et sont fréquemment demandées lors de l'examen ITIL.
Aperçu de la gestion des incidents
- Réduire, voire éliminer, les effets ou les occurrences des interruptions informatiques, des perturbations ou de la réduction de la qualité.
- Les utilisateurs doivent reprendre le travail le plus rapidement possible
- Engager des spécialistes compétents pour enregistrer, classer et attribuer tous les incidents.
- Les progrès doivent être contrôlés
- Les incidents doivent TOUS être résolus
- Le processus doit être clôturé APRÈS la résolution
Objectifs et avantages de la gestion des incidents
- Réduire l'impact sur les entreprises
- Améliorer la productivité des utilisateurs
- Obtenir un suivi des incidents indépendant et axé sur le client
- Rendre les informations sur l'accord de niveau de service (SLA) facilement accessibles
- Diminution du coût de l'activité
- Réagir rapidement et efficacement
- Surveillance active des domaines et des services des utilisateurs
- Empêcher les problèmes de s'aggraver
- Amélioration de la satisfaction des utilisateurs/clients
- Des opérations plus précises
- Prévenir le "trop grand nombre de cuisiniers"
Nous avons déjà défini les "incidences". Examinons maintenant le "problème".
Problems cause incidences. Incidences do not become problems. The problem is the underlying, unknown cause of one or more incidences. For example, one of the hard drives failed. If a disk fails, that is the incident. The problem however, is the underlying cause of the incident. Is it a configuration issue? Hardware issue? It is very important to remember the difference between an incident and a problem.
Enregistrements d'incidents et enregistrements de problèmes :
- Incident Records are end-user focused
- La gestion des rapports d'incidents se concentre sur la mesure des temps d'arrêt et de l'impact sur l'activité.
- Problem Records start with IT Management’s decision to invest IT resources and end-user downtime for root cause investigation and implementation of resolution
- Problem Records focus on Internal IT Processes
- Gestion Rendre compte des problèmes en se concentrant sur les causes profondes et en mettant en œuvre des solutions structurelles
Cycle de vie des incidents
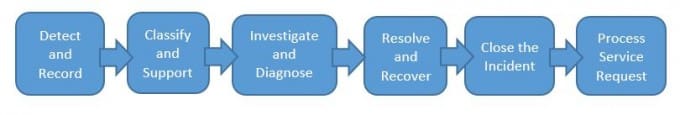
En tant que gestionnaire d'incidents, alors que vous mettez en place votre solution de service desk et de gestion des incidents, vous trouverez ci-dessous un diagramme typique du cycle de vie d'un incident sur lequel vous pourriez travailler.
La toute première étape consiste à détecter et à enregistrer. Il s'agit de l'acceptation initiale de la demande adressée au Service Desk. C'est à ce moment-là que l'enregistrement de l'incident est créé. La deuxième étape consiste à classer et à prendre en charge. Par exemple, le problème est-il lié à software ou à hardware , ou s'agit-il d'une demande de service ? L'incident est codé en fonction de son type, de son statut ou de son impact sur l'organisation. Est-il urgent ? Est-il critique ? Quelle est sa priorité ? Quel est son rapport avec l'accord de niveau de service ? À partir de là, l'utilisateur peut recevoir des suggestions du service d'assistance basées sur le script, ou peut-être, basées sur l'expertise pour résoudre l'incident ou contourner le problème, même s'il ne s'agit que d'une solution temporaire. S'il s'agit d'une demande de service, nous passerons alors à un processus différent puisque la demande de service n'implique pas les étapes d'investigation et de diagnostic.
If there are no known solutions for this particular incident, then it will be investigated and diagnosed further by the Service Desk group or go through the escalation process. If the solution was found, the issue can then be “resolved.” The “Resolve and Recover” step must take place. We have to have a solution to the incident. Once we have resolution to the incident, we move on to Closure. The user is asked if they are satisfied with the resolution. If they are, we close the incident. We might have a survey or a follow up if we wish to improve this process.
À chaque étape du processus, nous devrions assurer un suivi continu et une surveillance des progrès.
Escalade des incidents
Ici, nous avons deux types d'escalade différents : L'escalade horizontale et l'escalade verticale (cette question est fréquemment posée lors du test ITIL Foundation). En résumé, l'escalade d'un incident consiste à transmettre le problème à un niveau d'expertise/autorité plus élevé.
Chaque organisation devrait disposer d'un modèle d'escalade. Examinons-le en termes simples pour le démontrer.
Au niveau le plus élémentaire, nous avons tout d'abord le niveau 1. Ce niveau est responsable de l'enregistrement et de la détection de l'incident. L'incident se présente sous la forme d'une demande quelconque. Elle peut provenir d'un utilisateur, d'un client, d'un système, d'une application, etc. S'il s'agit d'une demande de service, par exemple si un nouvel employé a besoin d'un compte de domaine, ce type de demande, comme indiqué précédemment, passe par une procédure de demande de service. Lorsque l'incident atteint notre ligne de niveau 1, il passe à l'étape suivante, l'assistance. Si notre service d'assistance est en mesure de résoudre l'incident, nous passons directement à la récupération de la résolution et clôturons l'incident.
Toutefois, si le service d'assistance n'a pas été en mesure de résoudre l'incident, il y a escalade, ce que nous appelons le niveau 2. Cette escalade, comme nous l'avons déjà mentionné, peut être horizontale ou verticale.
- L'escalade fonctionnelle (horizontale) est un processus qui consiste à faire appel à des collègues, à du personnel interne possédant des compétences particulières ou des privilèges d'accès supplémentaires.
- L'escalade hiérarchique (verticale) consiste à s'adresser aux niveaux supérieurs. Par exemple, lorsqu'il s'agit d'un problème de réseau, nous devons contacter notre centre de données, qui ne fait pas partie de notre organisation.
Du point de vue de la conception du Service Desk, nous devrions d'abord développer l'escalade horizontale afin de nous assurer que nous disposons du personnel nécessaire pour aider nos utilisateurs.
Avantages, coûts et défis de la gestion des incidents
Examinons d'abord les avantages de la gestion des incidents :
- La réduction de l'impact des problèmes et des incidents sur l'activité, y compris les demandes de service, permet une plus grande efficacité.
- It will allow you to put in place proactive enhancements and changes that will make your business run smooth
- Gestion des accords de niveau de service axée sur l'entreprise
- By improving monitoring and performance, we receive better service quality
- Meilleure utilisation et efficacité du personnel
- By learning from incidents and problems, it will allow us to eliminate future incidents and service requests
- Aidez-nous à améliorer la satisfaction des clients/utilisateurs
Tout a un prix et des défis à relever. La gestion des incidents en a aussi :
- Planification initiale et mise en œuvre - communication, processus de formation
- Formation et montée en puissance
- Hardware et software les outils qui seront utilisés (système de suivi, système de billetterie)
- Les utilisateurs/le personnel contournent les procédures ; si le processus est trop complexe ou trop bureaucratique
- Arriéré d'incidents - surcharge des processus
- Trop d'escalades
- Absence de définitions claires, d'accords de niveau de service, d'engagement de la part du personnel et de la direction
Comme vous pouvez le constater, la mise en œuvre d'un processus de gestion des incidents présente de nombreux avantages et chaque organisation devrait disposer d'un processus de gestion des incidents clairement défini si elle souhaite soutenir efficacement ses clients internes et externes.
S'abonner à La Source
Stay secure with Keyfactor's monthly newsletter, packed with expert insights and practical steps for quantum-readiness.
Lire la suite
Crypto-Agilité grand public et autres tendances émergentes en cryptographie : Partie 2
En savoir plus
Nouvelle étude : Keyfactor découvre des risques dans 18% des certificats utilisés en ligne
En savoir plus